この記事は、CYBOZU SUMMER BLOG FES '26の記事です。
こんにちは、クラウド基盤本部の三村です。
サイボウズでは、オンプレミスのKubernetes基盤「Neco」でサービスを運用しています。
この記事では、IRQ Affinityの設定によってCPU PinningされたPodの動作が不安定になった事象について紹介します。
概要
Necoの基盤では、データセンター上にあるサーバーを用いてKubernetesクラスタを構築しています。 (詳細については以前の記事をご覧ください。)
KubernetesノードのOSにはFlatcar Container Linux(以下Flatcar)を使用しています。 このFlatcarをあるバージョンにアップデートした際に一部のPodの動作が不安定になるという事象が発生しました。 調査により、IRQ Affinityの設定とCPU Pinningの組み合わせが原因であることが判明しました。以下では、この事象の詳細について説明します。
用語解説
具体的な事象の説明に入る前に、IRQ AffinityとCPU Pinningについて簡単に説明します。
IRQ Affinityとは
IRQ Affinityとは、ハードウェア割り込み (IRQ: Interrupt Request) をどのCPUコアで処理するかを制御する仕組みです。例えばNICでパケットを受信した際に、どのCPUコアでその割り込みを処理するかを指定することができます。IRQ Affinityを適切に設定することで、パフォーマンスを向上させることができます。
各コアごとのIRQの処理具合は、/proc/interruptsで確認することができます。
例えば、CPUが2コアのVMの場合、以下のように表示されます。左側の数字がIRQ番号、右側の数字が各CPUコアで処理された割り込みの回数です。
$ cat /proc/interrupts
          CPU0       CPU1
10:       9546       9568 GIC-0  27 Level     arch_timer
12:          0          0 GIC-0  33 Level     uart-pl011
46:        503          0 GIC-0  36 Level     virtio0
49:          0          0 GIC-0  41 Edge      ACPI:Ged
50:          0          0 GICv2m-PCI-MSIX-0000:00:03.0   0 Edge      virtio2-config
51:          4          0 GICv2m-PCI-MSIX-0000:00:03.0   1 Edge      virtio2-req.0
52:          0         48 GICv2m-PCI-MSIX-0000:00:03.0   2 Edge      virtio2-req.1
53:          0          0 GICv2m-PCI-MSIX-0000:00:02.0   0 Edge      virtio1-config
54:          0          0 GICv2m-PCI-MSIX-0000:00:02.0   1 Edge      virtio1-control
55:          0          0 GICv2m-PCI-MSIX-0000:00:02.0   2 Edge      virtio1-event
56:       4453          0 GICv2m-PCI-MSIX-0000:00:02.0   3 Edge      virtio1-request
57:          0       2265 GICv2m-PCI-MSIX-0000:00:02.0   4 Edge      virtio1-request
58:          0          0 GIC-0  23 Level     arm-pmu
IPI0:       522        476       Rescheduling interrupts
IPI1:      3038       3572       Function call interrupts
IPI2:         0          0       CPU stop interrupts
IPI3:         0          0       CPU stop NMIs
IPI4:         0          0       Timer broadcast interrupts
IPI5:       343        265       IRQ work interrupts
IPI6:         0          0       CPU backtrace interrupts
IPI7:         0          0       KGDB roundup interrupts
Err:          0
また、IRQ Affinityの設定は、/proc/irq/<IRQ番号>/smp_affinity(バイナリ表記)または/proc/irq/<IRQ番号>/smp_affinity_list(数値表記)で確認・設定することができます。
smp_affinityの値は、CPUコアのビットマスクで表されます。CPU0とCPU1の両方を設定する場合、0b11= 3(10進数)となります。CPU0のみを設定する場合は0b01=1、CPU1のみを設定する場合は0b10=2となります。
/proc/interruptsの出力で、CPU0とCPU1の両方で処理されていそうなIRQ 10のAffinityを確認すると、0b11=3となっており、CPU0とCPU1の両方で処理されるように設定されていることがわかります。
$ cat /proc/irq/10/smp_affinity
3
また、CPU0のみで処理されていそうなIRQ 56のAffinityを確認すると、0b01=1となっており、CPU0のみで処理されるように設定されていることがわかります。
$ cat /proc/irq/56/smp_affinity
1
CPU Pinningとは
NecoのKubernetesクラスタでは、パフォーマンスが重要なPodに関してはCPU Pinningを行っています。
CPU Pinningとは、Podが使用するCPUを特定のコアに固定し、占有することです。これにより、Podが実行されるCPUコアが固定され、パフォーマンスが向上します。
Kubernetesでは、CPU Pinningを行うためにCPU Managerという機能が提供されています。 CPU Managerポリシーをstaticに設定すると、QoS ClassがGuaranteedのPodのコンテナのうち、CPUのrequestsが整数値のコンテナに対してCPU Pinningが行われます。
Pinningの状態はKubernetesノード上の/var/lib/kubelet/cpu_manager_stateで確認することができます。
例えば以下では、UUID622984e5-3e66-420e-9535-50a5f45151baのコンテナapp-aがCPU25-28にPinningされています。
また、defaultCpuSetは、CPU Pinningで使用されていないコアで、CPU PinningされていないPodが共有して使用します。
$ cat /var/lib/kubelet/cpu_manager_state | jq
{
  "policyName": "static",
  "defaultCpuSet": "0,32,35-63",
  "entries": {
    "622984e5-3e66-420e-9535-50a5f45151ba": {
      "app-a": "25-28"
    },
    "6e52a132-6314-4c98-9633-6ae25fae385b": {
      "app-b": "13-14,31"
    },
    "7996bf36-523a-4054-ac73-38c1d08c219c": {
      "app-c-suspend": "33-34",
      "app-c": "33-34"
    },
    "84536db7-2893-486f-807e-814e2702679a": {
      "app-d": "29-30"
    },
    "a1fd11b1-3256-4c08-9d47-16ad2f28bcb6": {
      "app-c-suspend": "15-16",
      "app-c": "15-16"
    },
    "db0c7280-fe44-4a03-a638-e116daf29641": {
      "app-c-suspend": "17-24",
      "app-c": "17-24"
    },
    "f4970dc9-47b5-4f8d-8107-766d24e52bec": {
      "app-a": "1-12"
    }
  },
  "checksum": 840012859
}
Podの動作が不安定になる現象
ここからは、実際に発生した事象について説明します。
事象の調査
Flatcarのバージョンアップ後、一部のPodの動作が不安定になる事象が発生しました。調査を進めていくと、不安定になっているPodは、CPU0-7にPinningされたPodであるということがわかりました。
そこで、/proc/interruptsでIRQの処理状況を確認してみると、バージョンアップ後からNICのIRQがCPU0-7のみで処理されており他のコアでは処理されていないことがわかりました。
以下に、問題が起きていたノードのIRQの処理に使ったCPU時間のうち、CPU0-7の割合のグラフを示します。
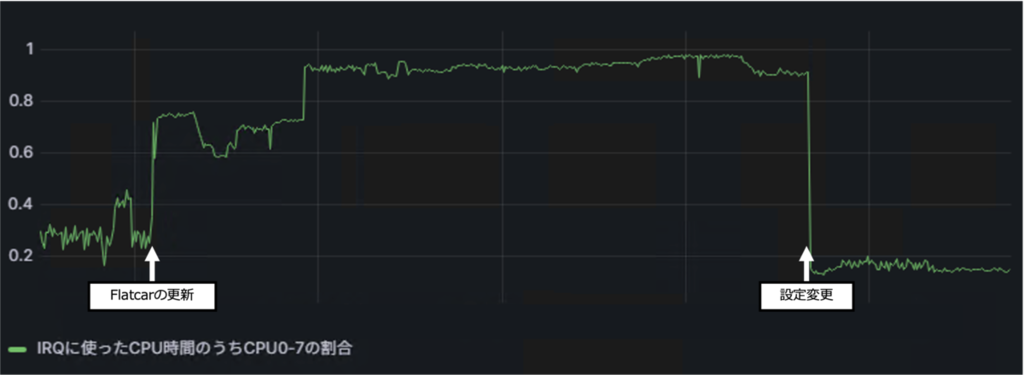
Flatcarの更新後から解消までの間、IRQの処理に使ったCPU時間はおよそ9割がCPU0-7で消費されているということがわかります。
また、NICのIRQ Affinityの設定を確認すると、以下のようにCPU0-7でのみIRQが処理されるように設定されていました。
$ cat /proc/irq/<NICのIRQ>/smp_affinity_list
0-7
これはFlatcarのバージョンアップによりカーネルに含まれているNICのドライバーが更新されてIRQ Affinityの設定が変更されていたことが原因でした。
CPU0-7が割り当てられていたのは、NICが接続されているNUMAノードのCPUを割り当てるように変更されていたためでした。
NICが接続されているNUMAノードは/sys/class/net/<NIC名>/device/numa_nodeで確認することができます。
$ cat /sys/class/net/<NIC名>/device/numa_node
0
そして、lscpuコマンドでNUMAノードの構成を確認すると、CPU0-7がNUMAノード0に所属していることがわかります。
$ lscpu
・・・
NUMA:
  NUMA node(s):              8
  NUMA node0 CPU(s):         0-7
  NUMA node1 CPU(s):         8-15
  NUMA node2 CPU(s):         16-23
  NUMA node3 CPU(s):         24-31
  NUMA node4 CPU(s):         32-39
  NUMA node5 CPU(s):         40-47
  NUMA node6 CPU(s):         48-55
  NUMA node7 CPU(s):         56-63
・・・
このことから、NICのIRQ処理がCPU0-7でのみ行われるようになったことで処理が集中し、同じCPUコアにPinningされたPodの動作が不安定になったと考えられます。
対策
NICのドライバー更新による変更はIRQを処理するCPUコアをNICが接続されているNUMAノードのものに割り当てるもので、おそらくはパケット処理のパフォーマンスの向上を目的としたものと考えられますが、Podの動作が不安定になるため我々の環境ではこの設定は適切ではありませんでした。従来のIRQ Affinityの設定でネットワークのパフォーマンスは十分出ていること等を考慮して、従来通り全てのCPUコアでIRQが処理されるようにすることにしました。
IRQの処理を分散させる方法として、一般的なのはirqbalanceを使用する方法です。irqbalanceは、CPUの使用状況を見てIRQの割り振りを自動的に調整するプログラムで、例えばUbuntuではsystemdのサービスとして動作するようになっています。 しかし、Flatcarではデフォルトではirqbalanceが提供されていません。また、Ciliumなど一部のソフトウェアではirqbalanceの使用は推奨されていないため(参考)、これを使用することはできませんでした。
我々の使用しているサーバーとNICの組み合わせでは、RSS(Receive-Side Scaling)が有効になっており、<ドライバ名>-<デバイス名>-TxRx-<0-63>のように1つのNICに対して各コアの数だけIRQが割り当てられていました。これらの各IRQに対して、OS起動時に/proc/irq/<IRQ番号>/smp_affinity_listを、各コアの番号を指定するように上書きすることで全てのCPUコアに分散させるようにしました。これはドライバ更新前のIRQ Affinityの設定と同等になります。
この設定はシェルスクリプトで記述し、FlatcarのIgnition(cloud-initのようなもの)で起動時に実行されるように設定しました。
これにより、CPU PinningされたPodが不安定になるという問題は解消されました。 前節で示したグラフの通り、設定変更後はFlatcarのバージョンアップ前の水準に戻っていることがわかります。
まとめ
この記事では、NICドライバの更新によってIRQの処理が一部のCPUに偏り、同じコアにCPU PinningされたPodの動作が不安定になった事象を紹介しました。
IRQ Affinityはハードウェア割り込みの処理を最適化するうえで重要な設定ですが、CPU Pinningと組み合わさったときに、Podのパフォーマンスを下げてしまうことがあります。今回のように、OSやドライバのアップデートでIRQ Affinityが暗黙のうちに変わるケースもあるため、注意が必要です。
CPU Pinningを行っている環境では、ぜひIRQ Affinityの設定 (/proc/interrupts や smp_affinity_list) にも目を向けてみてください。
