こんにちは!ソフトウェアエンジニアとして活動している @nissy_dev です。
サイボウズでは、各プロダクトを新しいインフラ基盤「Neco」に移行する取り組みを進めています。サイボウズ Office とメールワイズも例外ではなく、私たちのチームは 2024 年頃からこの 2 つの製品の移行に取り組んできました。
この記事では、その中から特に大変だった点や、設計・運用で工夫したトピックについて紹介します。
目次
- なぜ Kubernetes に移行するのか
- SQLite を利用する CGI を Kubernetes で動かす
- CGI のコマンドライン呼び出しを gRPC の API でラップする
- 大量のファイルを短い停止時間で移行する
- 移行先でもバックアップとリストアをできるようにする
- 外形監視を再設計する
- まとめ
なぜ Kubernetes に移行するのか
サイボウズでは kintone や Garoon などの各製品で Neco への移行が進んでいます。移行することで、テナント管理やリリースの仕組みを全社共通の基盤に統合でき、ハードウェアの世代交代やスケーリングも Kubernetes の仕組みに乗せられるようになります。
一方で、製品自体は 20 年以上続く C++ 製の CGI アプリケーションで、テナントごとのデータを SQLite で保持しています。この構成を Kubernetes 上で動かすには、製品固有の前提に合わせた設計が必要でした。
サイボウズ Office については、開発チームの紹介スライドも公開されているので、あわせて見てもらえればと思います。
SQLite を利用する CGI を Kubernetes で動かす
ステートフルワークロードと CGI の性質
Kubernetes 上でアプリケーションを動かすとき、ローカルファイルを操作しないステートレスなプロセスであれば、Pod はどのノードに配置されても構いません。Pod 間のデータの整合性は、データベースのロックなどの仕組みで担保します。
一方で、ローカルファイルを操作する一般的なステートフルプロセスは、複数のプロセスが同じファイルを同時に操作することを前提としていません。たとえば MySQL のように、1 つのデータディレクトリを 1 つのプロセスが占有するアプリケーションでは、複数の Pod から同じボリュームに同時に書き込むと、最悪の場合データが壊れてしまいます。
これに対して、サイボウズ Office とメールワイズのような CGI アプリケーションでは、リクエストごとにプロセスが起動するため、複数のプロセスが同じファイルを操作することが通常想定されています。同じファイルを安全に操作するにはプロセス間の排他制御が必要となり、そのために fcntl(2) や flock(2) などのファイルロックが使われます。
Pod とボリュームの配置に関する制約
サイボウズ Office とメールワイズで利用している SQLite の排他制御は fcntl(2) のファイルロックで実現されていて、このロックは同じカーネルを共有するプロセス間で機能します。そのため、同じボリュームをマウントする複数の Pod 間で排他制御を機能させるには、それらの Pod が同じ Kubernetes ノード上で動いている必要があります。
この制約を満たす構成として、次の 2 つを検討しました。
- 案 1: StatefulSet を利用する
- ステートフルなアプリケーション向けの標準的な機能で、Pod とボリュームの対応が保証される
- 一方で、更新時は古い Pod を削除してから新しい Pod を作成するため、リリースのたびにダウンタイムが発生する
- 案 2: Deployment に Pod Affinity と ReadWriteOnce の PersistentVolume を組み合わせる
- Pod Affinity で新しい Pod を古い Pod と同じノードに配置するため、同一ノード上でファイルロックによる排他が機能する
- Deployment のローリングアップデートによりダウンタイムなしでリリースできる
- ReadWriteOnce のボリュームは同時に 1 つのノードにしかアタッチされないため、万一 Pod が別のノードに配置されても、複数のノードから同じボリュームに書き込まれることはない
月 1 回の定期メンテナンス以外のタイミングでも安全にリリースをしたかったので、今回の移行ではダウンタイムが発生しない案 2 を採用しました。
採用した構成は次のようなイメージです。ローリングアップデート中は新旧の Pod が同じノードに並び、ファイルロックによる排他がその中で機能します。
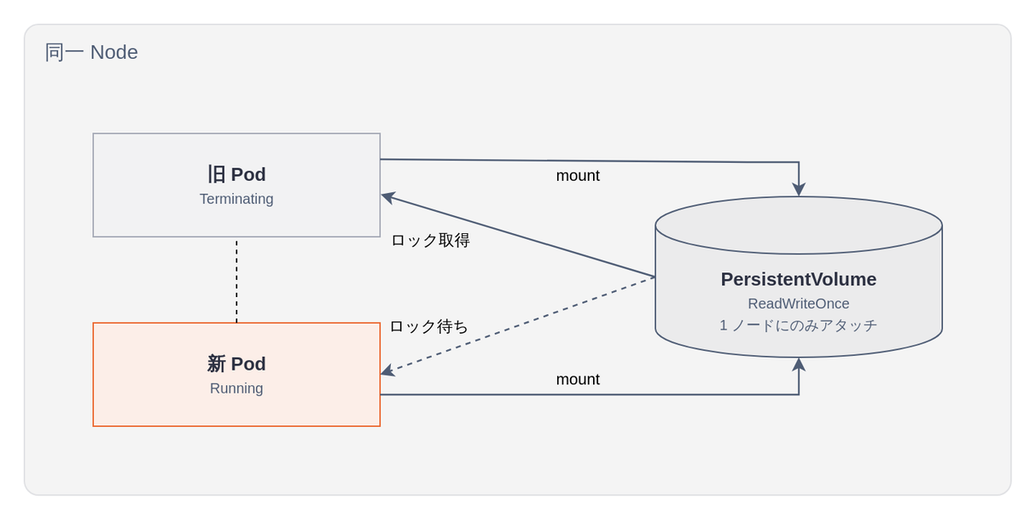
ローリングアップデートの安全性を検証する
ただし、案 2 のローリングアップデート中には、新旧の Pod が同じボリュームを同時にマウントする瞬間があります。この状態でも安全に運用できることを確認するため、次の 2 点について Linux カーネルの挙動を検証しました。
- 同一ノード上の新旧 Pod 間で fcntl(2) のロックが機能するか
- ページキャッシュが Pod をまたいで共有されるか
fcntl(2) のロックが Pod 間で機能することを確認する
検証には、同じボリュームをマウントする 2 つの Pod と、SQLite が利用する fcntl(2) のロックを獲得する次のような Go プログラムを用意しました。
package main

import (
    "fmt"
    "io"
    "os"
    "time"

    "golang.org/x/sys/unix"
)

func main() {
    file, err := os.OpenFile("lockfile", os.O_RDWR|os.O_CREATE, 0644)
    if err != nil {
        panic(err)
    }
    defer file.Close()

    lock := unix.Flock_t{
        Type:   unix.F_WRLCK, // 排他ロック
        Whence: io.SeekStart,
        Start:  0,
        Len:    0, // ファイル全体をロック
    }

    // 排他ロックを獲得できるまでブロックする
    start := time.Now()
    if err := unix.FcntlFlock(file.Fd(), unix.F_SETLKW, &lock); err != nil {
        panic(err)
    }
    fmt.Printf("排他ロックの獲得までにかかった秒数: %.2f秒\n", time.Since(start).Seconds())

    // ロックを保持したまま待機する
    time.Sleep(20 * time.Second)
}
このプログラムを 2 つの Pod で順に実行すると、後から実行した側の獲得までの秒数が先行プロセスの待機時間のぶんだけ長くなり、fcntl(2) のロックが Pod 間でも機能していることが確認できます。Pod はプロセス空間などが名前空間で隔離されているだけで、同じカーネル上で動くプロセスなので、これは自然な挙動だと思います。
ページキャッシュが Pod をまたいで残ることを確認する
製品の応答速度はページキャッシュに大きく依存しているため、Pod の入れ替え後も既存のキャッシュを引き継げるか確認する必要がありました。
こちらも同じボリュームをマウントする 2 つの Pod (memory limit は 1Gi) で検証しました。片方の Pod でファイルを書き込み、fincore コマンドでページキャッシュの状態を確認すると、もう片方の Pod からも同じキャッシュが見えることが分かりました。
# Pod A: 5GB のランダムデータを書き込む
$ dd if=/dev/urandom of=junk bs=1M count=5000
$ fincore junk
   RES  PAGES  SIZE FILE
977.2M 250165  4.9G junk

# Pod B: 同じファイルに対して同じ量のキャッシュが見える
$ fincore junk
   RES  PAGES  SIZE FILE
977.2M 250165  4.9G junk
また kubectl rollout restart で Pod を入れ替えた後も、このキャッシュは残っていました。少なくとも検証した構成では、新しい Pod が既存のページキャッシュを利用できるため、ローリングアップデートのたびにキャッシュが空になって応答速度が低下することは避けることができそうです。
CGI のコマンドライン呼び出しを gRPC の API でラップする
Web リクエスト以外にも CGI を呼び出す処理がある
サイボウズ Office とメールワイズには、Web のリクエストを処理する以外にも、テナントの初期化やメンテナンスモードの切り替え、ディスク使用量の集計といった処理があります。これらは CGI の実行ファイルをコマンドラインから呼び出す形で実装されています。
移行前は、こうした処理を VM 上のデーモンや SSH 経由のコマンド実行で行っていました。Kubernetes でも kubectl exec を使えば CGI のコマンドを実行できますが、呼び出し側が必要としているのは「このテナントを初期化する」「メンテナンスモードに切り替える」といった操作です。その単位で API を呼べるほうが扱いやすいため、アプリケーションの Pod にサイドカーコンテナを追加し、CGI のコマンドライン呼び出しを gRPC の API でラップすることにしました。
Pod 内の構成
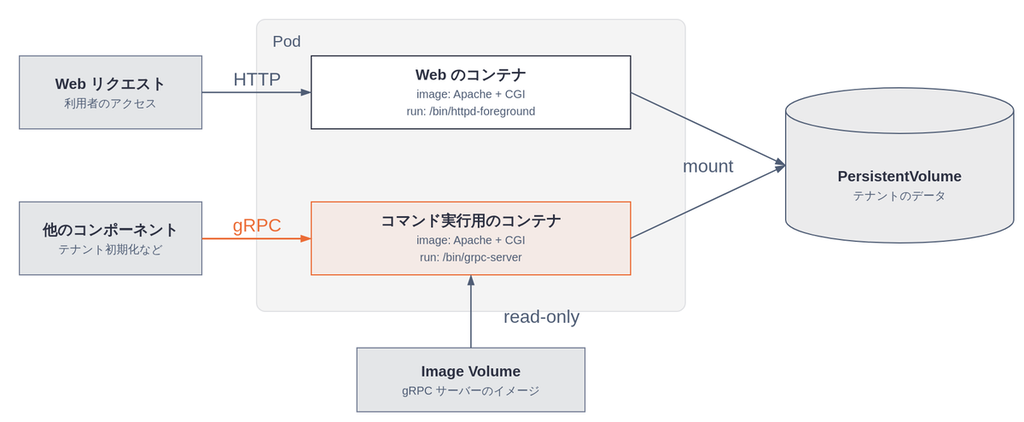
アプリケーションの Pod では、2 つのコンテナを動かしています。1 つは Apache と CGI を動かして Web のリクエストを処理するコンテナ、もう 1 つは gRPC サーバーとして動き、CGI のコマンドライン実行のための API を提供するコンテナです。どちらのコンテナも同じ製品イメージを使うので、サイドカー側にも CGI の実行ファイルと、CGI が動くのに必要な環境が揃っています。
テナントのデータを置いた PersistentVolume は、2 つのコンテナの両方にマウントしています。サイドカーは gRPC のリクエストを受けると、自分のコンテナ内にある CGI をコマンドラインから実行して、このボリューム上のデータを操作します。
サイドカーにすることで、コマンド実行のログを Apache のログと分けながら、データはそのまま共有できます。また、2 つのコンテナは常に同じ Pod に配置されるため、Pod の配置や複数ノードからの同時アクセスを追加で考える必要もありません。
gRPC サーバーの実行ファイルは、製品イメージには含めず、Kubernetes の Image Volume で別の OCI イメージから読み取り専用でマウントしています。当初は製品イメージに同梱していたのですが、そうすると gRPC サーバーだけを直したいときにも製品本体のリリースが必要になってしまいます。Image Volume を使うと、CGI を実行するための環境は製品イメージのまま揃えつつ、gRPC サーバーのビルドと配布だけを分けることができます。
大量のファイルを短い停止時間で移行する
事前転送と最終転送の 2 段階の構成
既存ユーザーのデータは、移行前の基盤から Neco のボリュームにコピーする必要があります。しかし、独自のデータ形式を採用している都合もあり、対象のファイル数は数億規模になるため、月 1 回の定期メンテナンスの時間内にすべてを転送することはできません。
そこで、転送を次の 2 段階に分けることにしました。
- 事前転送: サービスの稼働中に、rsync で大半のデータを転送しておく
- 最終転送: メンテナンス中に、mtime ベースの差分だけを転送する
実測では約 300 万ファイルの転送が 15 分程度で完了し、数億ファイル規模の移行になっても事前転送は 1 日程度で収まりそうだという見積もりが立ちました。
mtime ベースの差分転送の安全性を検証する
rsync は、デフォルトではファイルのサイズと mtime (最終更新時刻) だけを比較して転送対象を決めます。この方式は、「データが書き換わったのに mtime が更新されないファイルは存在しない」ということが前提になります。もしそのようなファイルがあると、最終転送でスキップされて古い内容のまま移行されてしまいます。
この前提が成り立つことを確認するため、Linux カーネルの挙動を調べました。
まず、通常の write(2) の経路です。POSIX では、write() が成功したときにファイルの mtime を更新対象としてマークすることが要求されています。
write() shall mark for update the last data modification and last file status change timestamps of the file
Linux (ext4) の通常の書き込みでも、データの書き換えと mtime の更新は一貫性が保たれるように処理されます。そのため、「データは新しいのに mtime が古い」という状態は基本的に起きません。
ただし、例外になりそうな経路が 2 つ見つかりました。
- O_DIRECT での書き込み: ページキャッシュをバイパスしてデバイスに直接 I/O する経路で、buffered I/O と混在した場合の一貫性は保証されない場合がある
- タイムスタンプを書き換えるシステムコール: utime / utimes / utimensat などを使うと、データの書き換えとは無関係に mtime を過去の値に設定できてしまう
これらについては、bpftrace で本番相当の環境を監視して、製品からは使われていないことを確認しました。O_DIRECT についてはファイルを開く経路で必ず通る security_file_open を、タイムスタンプの書き換えについては最終的に行き着く vfs_utimes をそれぞれフックし、対象のデバイスに対する呼び出しを検出しています。
移行先でもバックアップとリストアをできるようにする
サイボウズの多くのアプリケーションはステートレスなので、バックアップの対象は MySQL だけで済みます。一方で、サイボウズ Office とメールワイズのデータは Ceph のブロックデバイス (RBD) 上にあります。この RBD のバックアップには、ストレージ基盤チームが実装・構築した Mantle を使っています。バックアップの仕組みそのものは Mantle が担っており、私たちのチームはそれを利用して日次バックアップ、リージョン間レプリケーション、リストアを構成しています。
Mantle のバックアップは 2 段階になっています。
- クラスタ内バックアップ: RBD スナップショットを日次で取得する
- リージョン間レプリケーション: スナップショット間の増分を取り出し、オブジェクトストレージを経由して別リージョンのクラスタへ転送して、同じイメージを再構成する
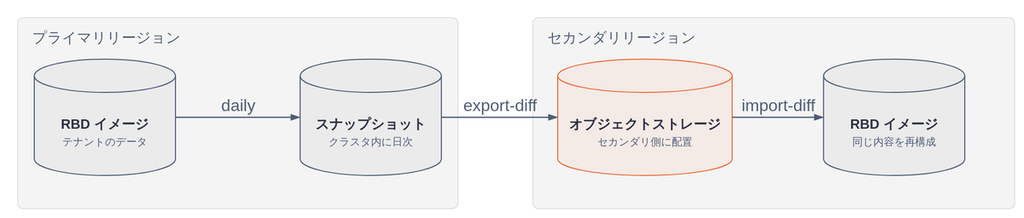
Mantle のアーキテクチャに興味のある方は、設計ドキュメント もあわせてご覧ください。
外形監視を再設計する
サービスが正常に動いているかどうかは、CPU 使用率やプロセスの生存だけでは分かりません。プロセスは動いているのにボリュームへの書き込みが返ってこない、といった壊れ方があるためです。そのため、実際にユーザーがアクセスするのと同じ経路でリクエストを送り、応答が返ることを確認する外形監視が必要になります。
移行前は、専用のデーモンが監視用テナントに毎秒アクセスして、1 秒以内に応答が返ることを確認していました。ただし、このデーモンは監視の実行からアラートの送信までを 1 つのコンポーネントで担っていたため、アラートの条件を変えるにも監視側の実装に手を入れることになります。移行を機に、ここを分離する形で作り直すことにしました。
移行後も検知したい障害は、アプリケーションやデータを置くボリュームが応答しなくなることです。具体的には、ボリュームへの読み書きが返ってこない、ボリュームが読み取り専用になる、Apache が HTTP リクエストを処理できなくなる、CGI を実行するプロセスが枯渇する、といった状況を想定しています。
これらを検知するため、アプリケーションに監視用のエンドポイントを追加しました。このエンドポイントは特定のファイルへの書き込みと fsync を実行し、成功すれば 200、失敗すれば 503 を返します。HTTP の応答だけでなくディスクへの書き込みまで確認することで、アプリケーションとボリュームの両方を監視できます。
監視用のコンポーネントは、このエンドポイントへアクセスして結果をメトリクスとして公開する exporter にしました。可視化とアラートの判定は Grafana とアラートルールに任せ、監視の実行とアラートの判定を分離しています。
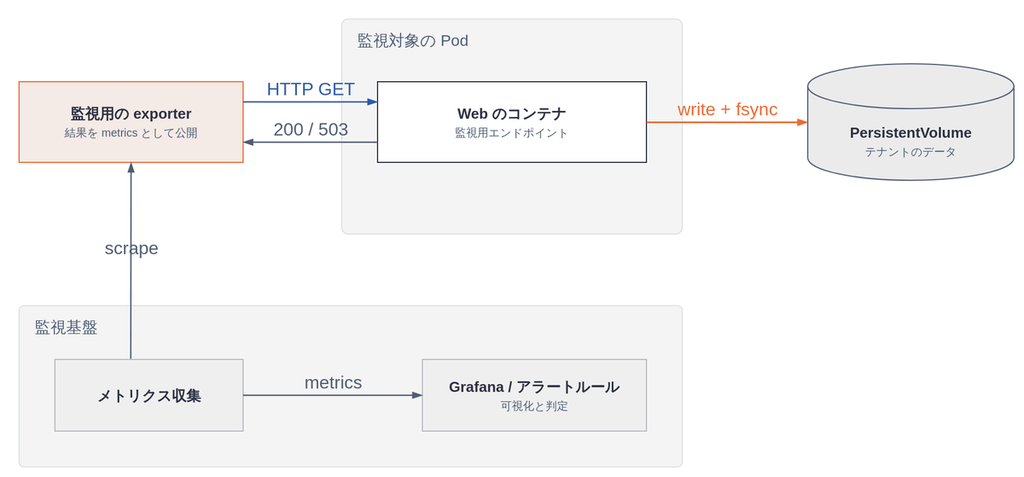
まとめ
この記事では、サイボウズ Office とメールワイズを Kubernetes に移行するために取り組んだ、ストレージ、データ移行、バックアップ、監視の設計について紹介しました。
今回の移行では、長く動いてきた製品の仕組みをすべて Kubernetes 向けに作り直すのではなく、既存の前提を活かせるところと、基盤に合わせて変更するところを切り分けました。ファイルロックやページキャッシュ、mtime については、カーネルの挙動まで確認したうえで既存の仕組みを活かしています。一方で、コマンドライン操作の API 化や監視については、Kubernetes 上で運用しやすい形に作り直しました。
移行を進めるなかで、アプリケーションをコンテナで動かすこと以上に、その製品が暗黙に頼ってきた OS やストレージの挙動を明らかにすることが重要だと分かりました。前提を一つずつ確かめ、必要な部分だけを置き換えることが、20 年以上続く製品を安全に新しい基盤へ移すための土台になったと思います。
もしこの記事を読んでサイボウズに興味を持った方がいれば、次のリンクからご応募お待ちしています!
