この記事は、CYBOZU SUMMER BLOG FES '26の記事です。
こんにちは!サイボウズでkintoneのフロントエンド刷新をしているSajiです。
※この記事は、筆者がTS Kaigi 2026で登壇した発表内容をもとに、記事用に加筆・修正したものです。登壇資料はこちらからご覧いただけます。
業務に残された「良くない型」で考える「TypeScriptの難しさ」 - Speaker Deck
kintoneのフロントエンド基盤刷新
開発当初からkintoneの大部分は、Google Closure Toolsというフレームワークで作成されています。しかしこの Google Closure Tools は、2024年にEOLになってしまっており、残念ながらフロントエンドを取り巻くエコシステムも当時から大きく変化してしまっています。
そのため、kintoneでは数年前から、これらのコードをReact/TypeScriptに置き換えるフロントエンド基盤刷新プロジェクトを進めています。既にいくつかの画面ではReact/TypeScriptへの置き換えが完了しており、今後も順次置き換えを進めていく予定です。詳しくは少し前の記事にはなってしまいますが、プロジェクト開始当時の記事をご覧ください。
自分の所属しているチームでは、kintoneのアプリ機能という、kintoneの中でも中核的な機能のフロントエンド刷新を担当しています。アプリ機能では、ユーザーが作成した「アプリ」に対して実際にレコードを登録・編集・閲覧できるような機能を提供しており、入力形態も多い複雑なForm、グラフやカレンダー表示などの可視化機能、ユーザーのコメント機能や細かい絞り込み検索機能など、フロントエンドとして複雑になりやすい機能を多く持っています。またkintoneではユーザーが書いたJavaScript/CSSでカスタマイズできる機能も提供しています。アプリ機能はこの中でも特に提供するJSAPIが一番多く、カスタマイズのニーズも高い画面群となっています。
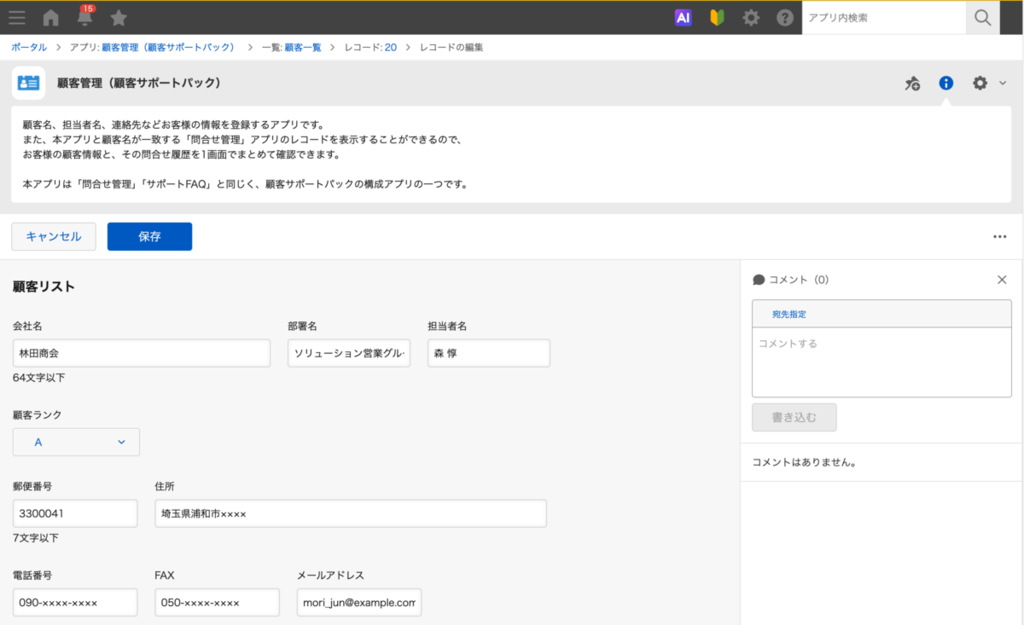
このように、アプリ機能はフロントエンドとしてかなり機能が多い画面群であるため、React/TypeScriptへの置き換えを進めるにあたっても設計や実装が複雑になりやすく、置き換えの難易度が高い領域と言えます。そしてロジックや設計が複雑になるほど、TypeScriptによる型レベルの保証は重要になっていきます。
今回は、そんなアプリ機能のフロントエンド刷新を進める中で行なっている、TypeScriptの型の改善活動について紹介したいと思います。
良くない型とは何なのか
型の改善活動を行うにあたって、一番最初に考えるべき問いは、そもそも「良くない型」とは何なのかということです。一般的には、any 型や as による強制キャスト、@ts-ignore による型チェックの無視などが良くない型とされていると思います。また、これらほどではないですが、雑な型ガード関数も場合によっては良くない型とされることがあります。
今回の改善活動では、最初にこれらの @ts-ignore / @ts-expect-error、as によるキャスト、型ガード関数などをAIに網羅させ、分析・分類をすることで実際の業務に残る「良くない型」とされる部分を探し出すことを行いました。
見つかったパターン
実際に検出された良くない型を分析していくと、特殊なものやレアなものを除いて、大きく7つの頻出パターンがあり、さらにそれら7つのパターンは3つに分類することができました。これらの3つはそれぞれ以下のように命名しています。
- 動的な境界での型落ち
- 動的な配列・Object変換
- unionの扱いの難しさ
1. 動的な境界での型落ち
これらはユーザー入力部分やエラーなどの動的な境界では標準的な機能では型を推定できないという問題です。放置してしまうと結果的にunknown型や本来より広い型をそのまま使うことになってしまいます。
具体的には以下のようなケースがありました。
1-1. DOMイベントやエラーのキャッチ時における広い型
以下のように、DOMイベントのコールバック関数の引数や、キャッチされるエラーなどは仕様上様々な値を許容するので型が広くなってしまいます。
button.addEventListener('click', (e) => {
  const target = e.target as HTMLButtonElement; // ← as
});

try { ... } catch (e) {
  console.error((e as Error).message); // ← as
}
1-2. とりあえずの unknown キャスト
もう一つよく見られたのが、何かしらそれっぽい型が欲しくてとりあえず unknown を経由してキャストしてしまうケースです。
const value = (config as Record<string, unknown>)[key];
このパターンは、テストコードやスクリプトなど、プロダクションコード以外の場所で特によく見かけました。プロダクションコード側でも皆無ではないのですが、その場合はasをした箇所を境界にして、広い型(あるいは誤った型)がそのまま後続の処理に波及してしまうため、より注意が必要な部分になります。
1-3. 文字列からBranded型・リテラル型への変換の限界
文字列を検証してからBranded型やリテラル型に変換したい、というのもよくあるケースです。しかし、TypeScriptは実行時のロジックと型を結びつける手段を持っていないため、たとえ正規表現でしっかり検証していたとしても、最後にはasが必要になってしまいます。
if (regex.test(rawString)) {
  const date = rawString as DateString; // ← 検証していてもasが必要
}
同様に、toLowerCase() のような組み込みメソッドの返り値は常に string として定義されているため、実際には小文字だけになっているとわかっていても、それを表現するリテラル型に戻すにはasを使うしかありません。
const lower = value.toLowerCase();
const typed = lower as LowerValue; // ← asが必要
対策
このような場面で現れるasや@ts-ignoreなどの良くない型は、「型ガード or ヘルパー1個」である程度安全に無くすことができます。例えば、DOMイベントのコールバック関数の引数であれば、以下のように型ガードを作ることで、asを使わずに型を安全に絞ることができます。
function isButtonElement(
  target: EventTarget | null,
): target is HTMLButtonElement {
  return target instanceof HTMLButtonElement;
}
文字列からBranded型・リテラル型への変換についても、同様に検証と型付けをセットにした型ガード関数や、組み込みメソッドをラップするヘルパーを1つ用意するだけで、asを局所化し、呼び出し側からは隠蔽することができます。
function isDateString(value: string): value is DateString {
  return regex.test(value);
}

function toLower<T extends string>(s: T): Lowercase<T> {
  return s.toLowerCase() as Lowercase<T>;
}
ヘルパーの内部にはasが残りますが、これを1箇所に閉じ込めてしまえば、呼び出し側では安全にリテラル型を扱えるようになります。また、これらを簡単にする方法としてZodのような型安全なバリデーションライブラリを使うのも有効です。
個別のケースを見ていくとむしろ人的な理由が多そうで、暫定のはずが残ってしまったり後から型が広がってしまったりすることが多いように見えました。面倒だからと後回しにされた検証や、一時しのぎのつもりで書かれたasが、そのままレビューを通り抜けて定着してしまっている、というのがこの章に共通する背景でした。
2. 動的な配列・Object変換
続いて多かったのが、配列やオブジェクトを動的に変換する際に型情報が落ちてしまい、asで辻褄を合わせているケースです。TypeScriptの配列・オブジェクト操作系のAPIは、実行時には安全な処理をしていても、型としては情報を落としてしまうことがよくあります。
2-1. 配列操作で型が想定と噛み合わないケース
includes は、as const で定義したreadonlyな配列に対して使うと、要素のリテラル型を厳密に要求するようになります。そのため、判定対象の値が広い型(例えばstring)の場合、そのままでは型エラーになってしまいます。
const STATES = ["DRAFT", "PUBLISHED", "ARCHIVED"] as const;

if (STATES.includes(state)) {
  // ← stateがstring型だとエラー
  // ...
}
これを避けるために内側でstate as 'DRAFT' | 'PUBLISHED' | 'ARCHIVED'とキャストしてしまったり、逆に配列側をstring[]として緩めてしまうと、今度はincludesの結果からリテラル型を得られなくなり、後続の処理でas Fieldのようなキャストが必要になってしまいます。
また、Array.isArrayによる判定も、配列であることまでは保証してくれますが、要素の型までは保証してくれません。そのため、判定後もvalue as JsApiUserData[]のようなキャストが必要になるケースが多く見られました。
2-2. オブジェクト変換で型が想定と噛み合わないケース
Object.fromEntries は、渡したタプルの配列からオブジェクトを構築しますが、返り値の型はキーのリテラル型が消えて Record<string, V> のように広くなってしまいます。
const entries: [FieldKey, string][] = [...];
const record = Object.fromEntries(entries); // Record<string, string>になってしまう
同様に、Object.keys の返り値は常に string[] で定義されているため、keyof typeof record のような、元のオブジェクトが持つキーのリテラル型として扱うことはできません。
これらはTypeScriptの構造的部分型(structural typing)ゆえの設計上の判断です。型に書かれていない余分なキーを持つオブジェクトであっても、その型として通ってしまう以上、Object.keysやObject.fromEntriesの返り値を安全に絞り込むことは、TypeScript自身の責務としては行われていません。
対策
このパターンについては、チームで共通の型ヘルパーを用意して対処するのが現実的だと感じています。例えば以下のようなヘルパーです。
function includesType<T extends readonly string[]>(
  arr: T,
  v: string,
): v is T[number] {
  return (arr as readonly string[]).includes(v);
}

function isUserArray(value: unknown): value is JsApiUserData[] {
  return Array.isArray(value) && value.every(isUser);
}

function fromEntriesTyped<K extends string, V>(
  entries: [K, V][],
): Record<K, V> {
  return Object.fromEntries(entries) as Record<K, V>;
}

function objectKeys<T extends object>(o: T): (keyof T)[] {
  return Object.keys(o) as (keyof T)[]; // ← ここだけはasが残る
}
こうしたヘルパーの内部には結局asが残ってしまうのですが、そのぶんの健全性は自分たちで保証するしかない、というのがこのパターンの難しいところです。とはいえ一度ヘルパーとして共通化してしまえば、呼び出し側のコードからはasを排除できますし、ヘルパー自体のテストも1箇所書けば済みます。
また、こうした組み込みAPIの型付けを補強するライブラリとしてts-resetのようなものを利用するのも選択肢の一つです。加えて、TypeScript自体もTS 5.5でfilterやeveryにinferred type predicatesが導入されるなど、こうした推論は少しずつではありますが改善されてきています。今後のバージョンアップでこの手のキャストが減っていくことも期待できそうです。
3. unionの扱いの難しさ
最後に紹介するのが、union型、特にdiscriminated union(判別可能なunion)まわりの扱いの難しさです。まず簡単におさらいしておくと、discriminated unionは以下のように、共通のプロパティ(多くの場合type)を使ってメンバーを判別できるunion型のことです。
type Field =
  { type: "TEXT"; value: string } | { type: "NUMBER"; value: number };

function render(field: Field) {
  if (field.type === "TEXT") {
    field.value; // string に絞り込まれる
  }
}
typeプロパティで分岐するだけで、対応するvalueの型まで正しく絞り込んでくれる、TypeScriptの中でもかなり強力な推論の一つです。しかし、このdiscriminated unionをうまく作れなかったり、うまく扱えなかったりするケースが業務コードには多く残っていました。
3-1. typeとvalueを別の式で組み立ててしまうケース
本来はtypeとvalueをセットで組み立てたいのに、実装上それぞれを別々の式で作ってしまい、結果としてdiscriminated unionではなく直積の型になってしまうケースです。
const type = getFieldType(fieldInput); // 'TEXT' | 'NUMBER'
const value = getFieldValue(fieldInput); // string | number

const field = { type, value } as Field; // ← 直積になってしまい、asが必要
typeとvalueをそれぞれ独立に導出してしまうと、TypeScriptとしては{ type: 'TEXT' | 'NUMBER'; value: string | number }という直積の型としてしか推論できません。本来欲しかったのはtypeが'TEXT'ならvalueがstring、typeが'NUMBER'ならvalueがnumber、という組み合わせが保証されたdiscriminated unionなのですが、別々の式で組み立てている以上、その対応関係は型からは読み取れなくなってしまいます。
このケースの改善策は、factory関数のような形で、typeとvalueをセットのまま組み立て切ってしまうことです。
function createField(typeInput: FieldType, fieldInput: unknown): Field {
  switch (typeInput) {
    case "TEXT":
      return { type: "TEXT", value: String(fieldInput) };
    case "NUMBER":
      return { type: "NUMBER", value: Number(fieldInput) };
  }
}
switchの各caseの中でtypeとvalueを同時にリテラルとして返すことで、asを使わずにdiscriminated unionを構築できます。
3-2. 引数のunionから返り値を推論しづらいケース
もう一つ厄介なのが、引数として渡されたunionの型から、返り値の型をうまく推論できないケースです。例えば以下のような関数を考えます。
function validate<T extends FieldA | FieldB>(
  value: unknown,
  type: T["type"],
): Result<T> {
  // 関数の中ではTが確定していないため、asが必要になる
  return ok({ value: String(value), type } as T);
}
関数の外から見るとtypeによってTが一意に決まるように見えますが、関数の実装の中ではTはあくまでジェネリックなまま確定していません。そのため実装の中でTを組み立てようとすると、結局asを使わざるを得なくなります。これはoverloadを使うことである程度解決できますが、Fieldの種類が増えるたびにoverloadのパターンも増えていくため、次第に冗長になっていきます。
さらに厄介なのが、キーごとに引数・返り値の型が変わるハンドラを登録するようなパターンです。
type Apis = { getId: () => string /* ... */ };

const callHandler = async <K extends keyof Apis>({
  apiPath, // K
  apiArgs, // Parameters<Apis[K]>
}: JsApiCallData[K]) => {
  const handler = apiHandlers[apiPath]; // Apis[K]
  return await handler(...apiArgs); // ← エラー !!
};
キーから引いてきたハンドラの型は各ハンドラ(関数)のunionになりますが、関数の引数は反変の位置にあるため、このunionの関数が実際に受け付けられる引数は「全引数型のintersection」になります。一方で呼び出し側が渡せるのは「各ハンドラが期待する引数のunion」なので、両者がうまく噛み合わずエラーになってしまいます。API全体分のoverloadを書き切るのは現実的ではなく、かといって設計で逃げるのも難しいため、こうしたケースについては、ある程度割り切って局所的にasを使い、なぜそうしているのかの理由コメントを添えておくのが現実的な解決策になることが多いように感じます。
なお、こうしたcorrelated unionsまわりの推論は、TypeScript自体もv4.6やv4.7、v5.5、v5.9といったバージョンで徐々に改善が続けられている領域です。今すぐには解消できなくても、バージョンアップによって将来的により自然に書けるようになる可能性がある部分だと捉えています。
対策
discriminated unionが崩れてしまう場合は、typeとvalueをセットで組み立てるfactory関数を用意することで、asを使わずに構築し切ることができます。一方で、ジェネリックな引数から返り値を推論するパターンについては、TypeScriptの表現力の限界にぶつかっている部分も大きく、無理に型で解決しようとせず、局所的なasと理由コメントで割り切ることも一つの現実的な選択肢だと考えています。
パターンをどう分類するか
ここまで紹介してきた7つのパターンは、「どう対策するか」という軸で見ると、大きく2つの観点で整理できることがわかりました。
- その型の緩さが、外部との境界由来で生まれているのか、コード内部由来で生まれているのか
- 型ガードやヘルパーを使って、安全な型の世界に押し戻せるのか、押し戻せないのか
この2軸で分類すると、以下のようになります。
- A. 境界由来 × 押し戻せる: DOMイベントやエラーのキャッチ、Branded型・リテラル型への変換、
unknownを含む型へのasなど。この領域は、Zodなどのスキーマライブラリを含めた型ガードがしっかり報われる領域です。「型ガードを書ける場所では書く」ということをチームの規約として明文化する価値があります。 - B. 内部由来 × 押し戻せる:
filterやincludes、Object.fromEntries、discriminated unionの生成など。この領域は、チームで型ヘルパーや型ガード集を持つことで対策できます。ただし、何でもかんでもヘルパーに集約すればいいわけではなく、設計を集約することのメリットとDRYにしすぎることのデメリットは、都度見極める必要があります。 - C. 内部由来 × 押し戻せない: 引数に応じた返り値の推論、ジェネリックな引数を持つハンドラなど。この領域は局所的に
asや@ts-expect-error+理由コメントで割り切りつつ、TypeScript自体の進化を追いかけていくのが現実的な向き合い方になります。
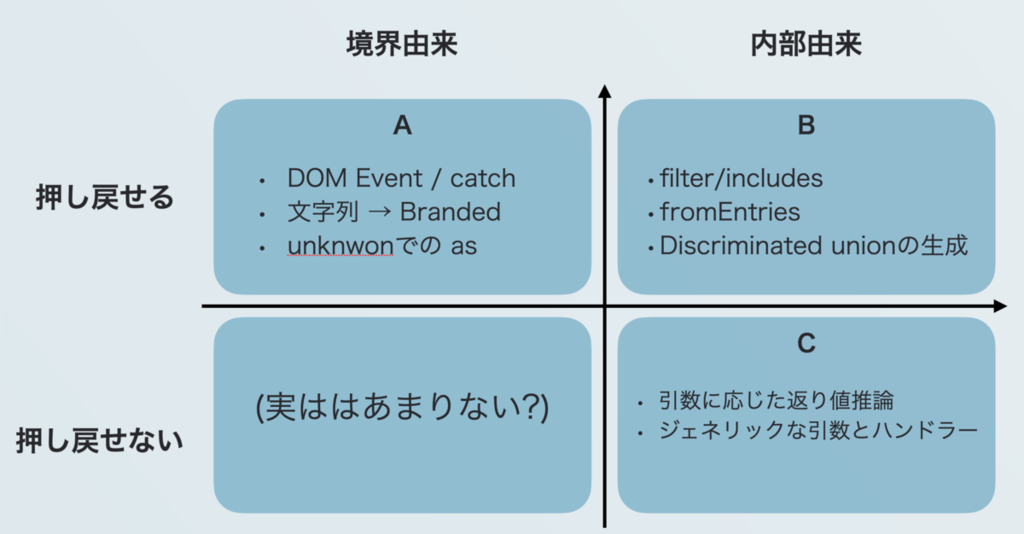
ちなみに「境界由来 × 押し戻せない」に該当するケースは、分析していく中ではほとんど見当たりませんでした。境界での型の緩さは、多くの場合きちんと検証さえすれば型ガードで押し戻せる、というのは一つの発見でした。
この分類をふまえると、実際にコードを書いたりレビューしたりする際には、以下のようなチェックリストで「良くない型」を見直せそうです。
- 外部との境界を跨いでいないか
- 配列・オブジェクトの動的な変換を経由していないか
typeとvalueを別々の式で組み立てていないか- 関数の中でジェネリックな型を確定させようとしていないか
- 同じ妥協が何度も繰り返されていないか
改善活動と運用へ
ここまでは登壇でも紹介したパターン分析の内容でしたが、実際にチームではこの分析結果をもとに、いくつかの運用を見据えています。
lintでの規約化
ban-ts-commentルールを使って、@ts-expect-errorや@ts-ignoreを使う際には必ず理由コメントを書くことをルールとして強制するように段階的に移行しています。
具体的には以下の段階を踏んで少しずつ厳しく・改善していく予定です。
ts-ignoreに理由コメントを書くことを強制する(現状)ts-ignoreをts-expect-errorに変えていくts-expect-error自体の削減
Oxlintでの設定例
{
  'typescript/ban-ts-comment': [
    'error',
    {
      'ts-expect-error': 'allow-with-description',
      'ts-ignore': 'allow-with-description'
    }
  ]
}
AI Codingへの対応
AI codingによってコードを生成するのが当たり前になってきた今、AIに良くない型とその対策を学習させることも重要です。幸いにも今回の調査で「良くない型」には大抵パターンがあり、パターンごとに取れる対策もある程度決まっていることがわかりました。
そのため、現在はAI向けのドキュメントとしてまとめてskillとして登録し、試験的にレビューやコード生成の際に参照させています。具体的には一般的な「良くない型」のパターンとその対策をまとめたドキュメント(上記の部分)と、実際のコードベースとの対応やプロダクト独自事情をまとめたドキュメントをskillとして登録しています。またskillを利用した際に実際に遭遇した「良くない型」の事例と対応、対応の評価を記録するようにし、定期的にドキュメントへ反映させることで、学習していくようにしています。
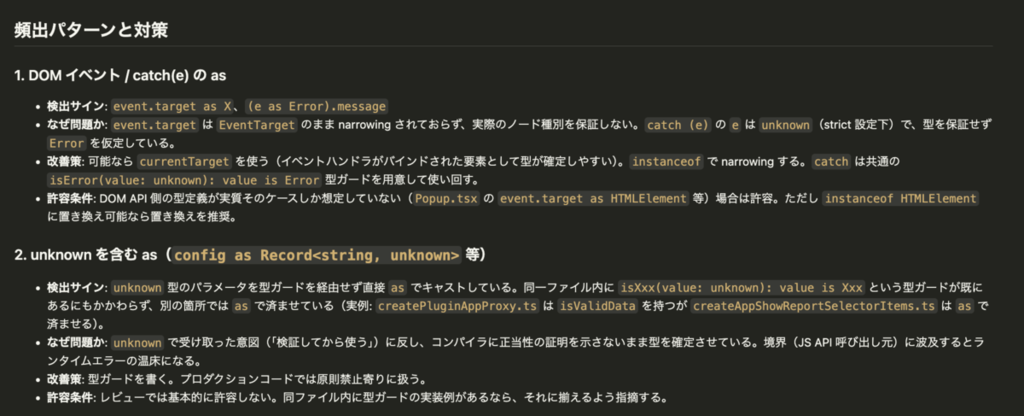
まだ個人で試している段階ではありますが、以前よりは無理やりなasや@ts-expect-errorが減ってきている実感があります。すでに社内ではskillを共有できる仕組みが整いつつあるので、今後はチーム全体やプロダクト全体での共有・活用を進めていきたいと思っています。
まとめ
業務に残る「良くない型」には、大抵の場合パターンがあります。今回のケースでは、分類してみると数パターンに収まり、その半分は設計上の歪みが原因、もう半分はTypeScriptそのものの表現力の限界が原因、というくらいの割合に落ち着きました。パターンに分けることができれば、チームとして優先度をつけて少しずつ改善していくことができますし、新しく書く際も気をつけやすくなります。またこうしたパターン分析は、単にasを減らすための作業にとどまらず、自分たちの設計のどこが難所になりやすいのか、TypeScriptがどこまでを保証してくれてどこからは保証してくれないのか、といったことを知るきっかけにもなります。
幸いなことに、最近ではAIの能力が向上していますから、今まで大規模なコードベースでは難しかった今回のような調査もかなり容易に行えるようになってきています。さらに調査結果をskillなどにしておけば、レビューの段階で良くないパターンに気づけたり、そもそもコード生成の段階で良くない型を避けるようにAIに学習させることもできます。
もし手元のプロダクトにも「良くない型」が残っているようであれば、ぜひ一度、皆さんのチームでも収集・分析をしてみてください。
