Mythos 級 AI の公開をリスクと捉え、AI を用いた製品のセキュリティスキャンを行うハーネスを開発しました。
ハーネスを "Horos" と名付けました。
Horos 境界標/定義・術語: サンドボックス境界と「判定基準」の二重義
ハーネスエンジニアリング/ループエンジニアリングなど、いろいろなところで聞く言葉ですが、私たちが開発した「セキュリティスキャンハーネス」とはどういうものだったのか。
今回は、その概要をご紹介します。
- Mythos 対策プロジェクトの 2 ヶ月(概要編)
- > Mythos 対策プロジェクトの 2 ヶ月(ハーネス編)
- Mythos 対策プロジェクトの 2 ヶ月(LLM-Wiki 編)
- Mythos 対策プロジェクトの 2 ヶ月(まとめ編)
セキュリティスキャンハーネス "Horos"
ソースコードを渡し「脆弱性をスキャンして」と言えば、ある程度のスキャンはしてくれます。
しかし、単純なプロンプトを単発で回しても、十分な結果は得られません。
これはモデルの性能だけの問題ではありません。
そもそも脆弱性のスキャンは、ソースコードを細かく解析する必要がありますが、モデルは一度に全てのコードをつぶさに見てくれるわけではありません。
一定の観点で怪しそうな場所を見つけ、そこを重点的に見るような「偏り」をもってスキャンをします。
大事なのは、スキャンを何度も回すことです。
でも同じ情報だと、何度も回しても同じようなところを見て、同じような結果を出してきます。
今回のスキャンはどこを見たのか、その結果何が検出されたのか、そのうちどれが本当に脆弱性で、どれが誤検出だったのか。
前回の結果を次のコンテキストに積む「フィードバックループ」が非常に重要です。
セキュリティスキャンハーネスの最も重要な点は、このループを回せるような土台を整えることでした。
サンドボックス環境
脆弱性情報は、コンフィデンシャルな情報です。
本来は AI に渡すのもためらわれるような、重要な情報ですよね。
でも、今回はその情報を AI 自体に見つけてもらっているわけです。矛盾しています。
もちろん、学習されないように設定することはできます。そこは信じるしかありません。
それでも、AI がうっかりその情報を外に投げ出したりしたら、それ自体がインシデントになってしまいます。
そこで、AI が安心して活動でき、私たちも安心して見守れるように、実行はサンドボックス環境で行う必要があります。
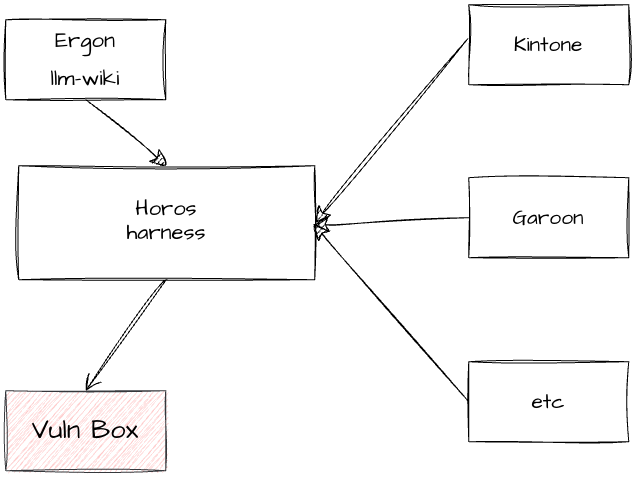
Horos では、AI の実行は AWS のインスタンスに閉じ込めることにしました。
AWS インスタンスを起動し、ソースコード、LLM-Wiki、各種 SKILL などの必要な情報を AWS 内に持ってきて、ガッチリ蓋をしてループを流す。
プロダクトのリポジトリを指定したら、そこまで実行して結果だけが取得できるよう自動化しています。
社内で「スキャンした方が良さそう」と思ったひとは、少しコマンドを叩くだけです。
SAST と DAST
脆弱性のスキャンには二種類あります。
いろいろありますが、私たちはこう定義しました。
- SAST(Static Application Security Testing): 静的なスキャン
- 渡したソースコードを眺めてもらい、怪しいところを教えてもらう。
- DAST(Dynamic Application Security Testing): 動的なスキャン
- 実際にアプリケーションを動かしながら、挙動を見て怪しいところを見つけてもらう。
最初は SAST だけをやっていました。ところが、長年バグハンターから様々な報告を募って改善してきた kintone は、早い段階で検出量が頭打ちになります。
これ以上精度の高い検出をするためには、AI が実際にアプリを動かして、挙動を見ながら攻撃する DAST にシフトする必要があると判断しました。
実行はサンドボックスのなかで、そこにはソースコードがあるので、開発者が行うのと同じように dev server を立ち上げることができます。ソースを調べながら、怪しそうなところにログを仕込み、動かしてコンソールや Dev Tools の出力を見ることもできます。あ、AI 自身がって意味です。
ちなみに、それができると「攻撃の再現」つまり PoC を作って、本当に攻撃できるのか試してもらうこともできます。SAST のレポートにも「再現方法」は付けてもらっていましたが、人間が実際にやっても再現しないことが多くあったので、そこまでやってもらえれば人間の負荷もかなり下がります。
ところが、DAST をきちんと回すのは、非常に負荷が高く、トークンもめちゃくちゃ消費します。サンドボックスのなかで実行するという制限が邪魔になることもあれば、アプリ側の更新に追従して仕組みを維持するのも大変です。思ったほどすんなり「精度が上がった」とはなりませんでした。
そこで、全ての製品ではなく「SAST である程度頭打ちした」と PSIRT にみなされた製品だけが、DAST のフェーズに移るようなルールになりました。「SAST 卒業」という概念が生まれ、各製品が目指す指標の 1 つになったりならなかったりしています。
今 DAST を回しているのは一部だけで、ここからより細かい脆弱性を見つけていくには、精度の高い DAST を回していく必要があり、ここにはまだ課題が多くあります。
脆弱性診断スキルと MCP
サイボウズには PSIRT という、脆弱性対応のスペシャリストがいます。
Horos が見つけた脆弱性は、最終的には PSIRT に報告して、人間の手で再現確認や、重要度の指定などを行っています。
しかし、Horos によって偽陽性含めてレポートの数が増えてしまうと、トリアージのコストが上がってしまいます。
そこで、AI の検出結果を PSIRT に報告する前に、「すでに報告されていないか」「本当に再現するか」などを、AI 自身が事前にトリアージするようにしました。
このトリアージは、実際にトリアージを行ってきた PSIRT のメンバーが、自分たちが行っていることを SKILL としてまとめて、それを Horos のなかに取り込むことで実現しています。
過去の脆弱性レポートは、MCP 経由で Horos から参照できるようにしています。
これによって Horos が AI Slop の原因になることを防げ、PSIRT は本当に見るべきレポートに集中できるようになりました。
ステップの分割
SAST でソースコードをスキャンし、出力を評価し、再現方法を付与してレポートまでやると、結構な時間がかかります。
kintone で言うと 100 分くらいでしょうか。
ところが、もし途中で落ちてしまうと、全ての結果が消し飛んで、せっかく溶かしたトークンも無駄になってしまいます。
そこで、私たちはこの長いスキャンを、なるべくステップで区切り、中間結果を保持するように分割しました。これならもしタスクが落ちても、犠牲はそのステップだけで済みます。
ステップごとの中間結果が残っていることは、フィードバックループの観点でも良い方向に働きました。全部終わってまるっとレポートを残すより、細かいレポートがコンテキストに載るほうが、情報が充実します。
このステップを区切ったり、再実行したりするといった補助も、「ループを回し続ける」というハーネスの大事な役割です。
といっても、現状はあまり重たいフレームワークなどは使わず、ナイーブに実装しています。それも検討はしたんですが。
本当は「24 時間 365 日」回し続けたいですが、それはなかなかトークン代が、、ねぇ。。なので、まあ、たまに落ちてもそこまで困らない仕組みになっていれば、事足りているのが現状です。
こうして、「スキャンを安全に回し続け、回すほど精度が上がる」ためのハーネスである Horos が完成しました。
でも、Horos だけでは精度向上は難しいです。Horos には、すごく強い相方がいます。
次回はその LLM-Wiki である Ergon ちゃんについて紹介します。
【変更履歴】
2026年9月4日 連載記事のリンクを追加しました。
